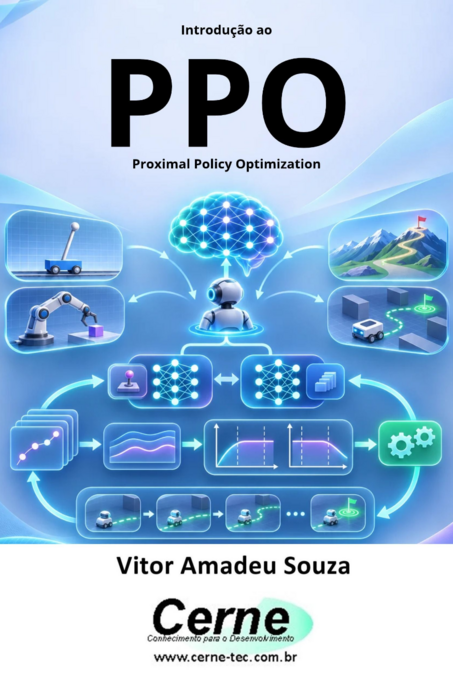
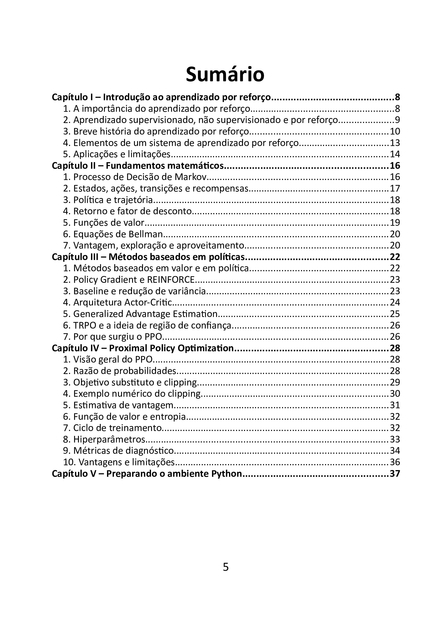
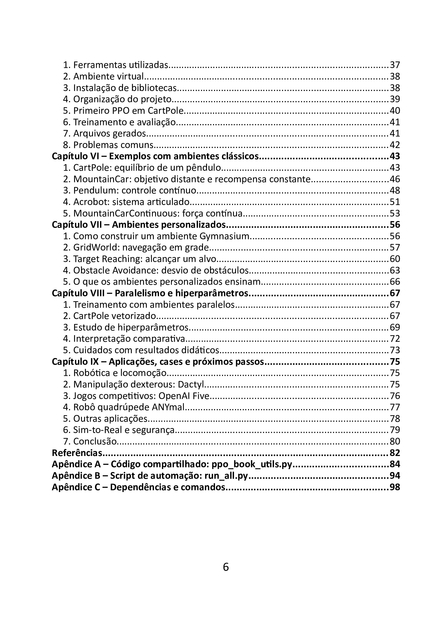
A proposta desta obra é apresentar o algoritmo Proximal Policy Optimization (PPO), desde os fundamentos do aprendizado por reforço até sua implementação em Python. O conteúdo avança gradualmente, introduzindo os conceitos, a matemática e os exemplos práticos.
A parte prática utiliza Gymnasium e Stable-Baselines3. São apresentados ambientes clássicos e ambientes personalizados para navegação, alcance de alvos e desvio de obstáculos. Os códigos completos e os módulos auxiliares aparecem nos capítulos e apêndices.
Os resultados foram obtidos em uma execução, com seed 42, 5.000 passos nos experimentos principais e 3.000 passos em cada configuração de hiperparâmetros. A finalidade é ilustrar o comportamento do algoritmo, inclusive quando o agente ainda não conclui a tarefa.
| Number of Pages | 100 |
| Edition | 1 (2026) |
| Format | A5 (148x210) |
| Binding | Paperback with Flaps |
| Paper Type | Estucado Mate 150g |
| Language | Portuguese |
Do you have complaints about this book? Send an email to [email protected]
Click Login to leave your comment on the book.